

🗓️ Mis à jour le
Le fichier llms.txt est une proposition destinée aux webmasters qui souhaitent orienter les agents IA vers les ressources les plus pertinentes d’un domaine. Contrairement au robots.txt qui restreint l’accès, cette convention, qui n’est pas un standard officiel, vise à faciliter la lecture de votre site par les agents IA en leur offrant un index structuré en Markdown. Ce tutoriel vous guide dans la création, le formatage et le déploiement de ce fichier à la racine de votre serveur. Comptez environ 20 minutes pour une implémentation complète sur un site standard.
| Paramètre | Détails |
|---|---|
| Temps estimé | 15 à 30 minutes |
| Niveau technique | Intermédiaire (connaissance du Markdown et accès serveur) |
| Outils requis | Éditeur de texte (VS Code, Sublime), client FTP/SFTP ou pipeline Git |
| Accès nécessaires | Accès à la racine du site (dossier public_html ou www) |
Prérequis : le matériel nécessaire avant de commencer
Avant d’ouvrir votre éditeur de code, assurez-vous de disposer des droits d’écriture sur votre hébergement. La mise en place ne nécessite pas de base de données, car nous travaillons sur des fichiers statiques lus directement par les crawlers IA.
Les outils et accès indispensables
Vous avez besoin d’un éditeur de texte simple gérant l’encodage UTF-8. Pour le transfert, un accès SFTP est la norme, bien que la plupart des déploiements modernes passent par une intégration continue (CI/CD). C’est le cas classique en maintenance SEO (Search Engine Optimization) : sans accès au répertoire racine, vous ne pourrez pas rendre le fichier accessible à l’URL attendue par la spécification llms.txt. Vérifiez également que votre serveur n’applique pas de règles restrictives sur les fichiers .txt dans les répertoires publics.
Comprendre la structure attendue par la spécification
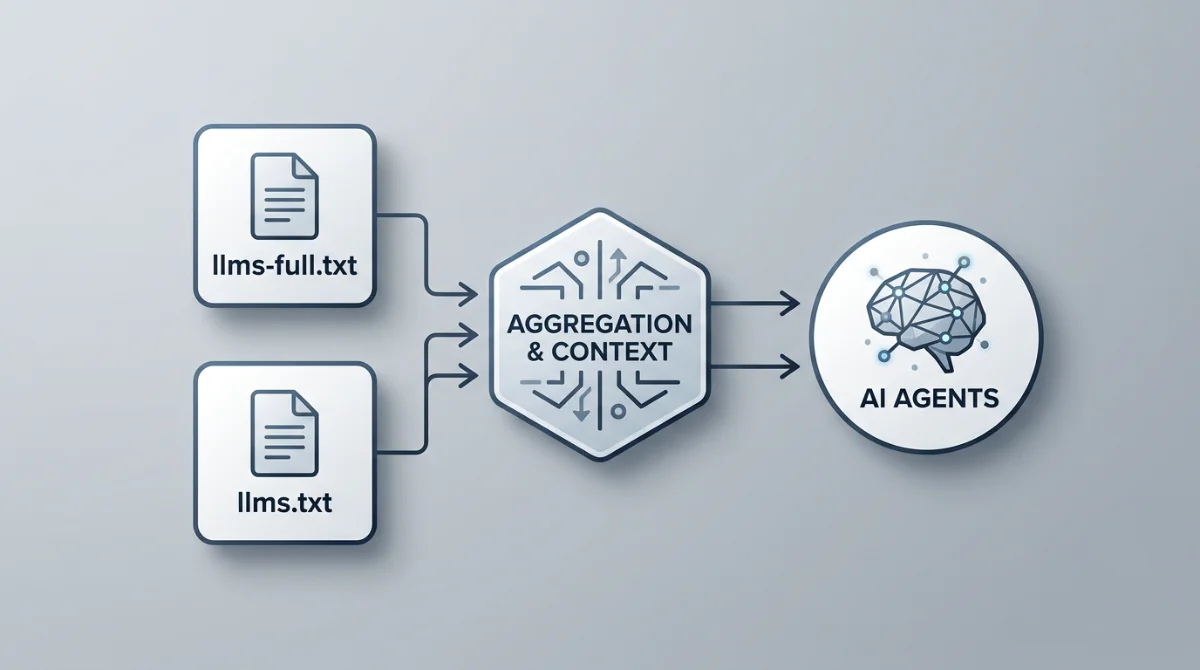
La proposition, publiée en septembre 2024 par Jeremy Howard (Answer.AI) sur llmstxt.org, repose sur une distinction claire entre deux entités. Le fichier principal, nommé llms.txt, sert de résumé ou d’index. Il contient des liens vers les documents essentiels. À l’opposé, le fichier llms-full.txt est une version agrégée destinée à être consommée d’un bloc. L’objectif est de réduire le bruit (menus, publicités, scripts) pour économiser la fenêtre de contexte des modèles de langage. Pensez-y comme à une documentation technique épurée, débarrassée de l’interface utilisateur habituelle.
Étape 1 : rédiger l’en-tête et le bloc de contexte de votre llms.txt
Commencez par créer un fichier nommé exactement llms.txt. La syntaxe doit être du Markdown strict pour garantir une interprétation sans faille par les outils de GEO (Generative Engine Optimization).
Définir le titre h1 et le résumé principal (blockquote)
La première ligne du fichier doit obligatoirement être un titre H1 précédé d’un dièse (#). Il indique le nom de votre projet ou site web. Juste en dessous, insérez un bloc de citation utilisant le caractère « > ». Ce bloc doit décrire l’utilité du site en deux ou trois phrases percutantes. Évitez les adjectifs marketing et concentrez-vous sur les faits. Par exemple : « > Plateforme de services spécialisée dans le netlinking et l’analyse de données SEO pour les agences digitales. » Cette précision aide l’IA à comprendre immédiatement si elle se trouve sur une ressource pertinente.
Rédiger la section d’informations clés du projet
Après le résumé, vous pouvez ajouter des détails factuels. Voici un exemple type de structure à copier et adapter :
# Nom de votre Projet
> Description concise de votre activité, de vos services ou de votre documentation technique.

- Version : 1.2.0
- Licence : MIT
- Statut : Production
Cette partie permet aux agents IA de situer le contexte temporel et légal du contenu qu’ils s’apprêtent à analyser. C’est un gain de temps précieux pour l’algorithme qui n’a pas à déduire ces informations du reste des pages.
Étape 2 : structurer les liens vers vos ressources et documentations
Une fois le contexte posé, vous devez lister les points d’entrée vers vos contenus. C’est ici que vous orientez réellement le comportement des robots.
Organiser les sections thématiques en h2
Utilisez des titres de niveau 2 (##) pour regrouper vos liens par thématique. Pour un site d’agence, vous pourriez avoir des sections comme « Services », « Études de cas » ou « Documentation API ». Cette organisation hiérarchique est fondamentale pour l’architecture RAG (Retrieval-Augmented Generation), car elle permet à l’IA de sélectionner uniquement la branche qui l’intéresse.
Formater les liens en Markdown avec descriptions explicatives
Chaque lien doit être explicite. N’utilisez pas d’ancres vagues. La structure recommandée est : [Nom de la ressource](URL) suivie d’une brève explication du contenu. Sur le terrain, vous verrez souvent des webmasters se contenter d’une liste de liens brute. C’est une erreur. L’ajout d’une description textuelle (environ 15 mots) permet à l’agent de comprendre la valeur ajoutée de la page sans avoir à la télécharger préalablement. Une qualité des liens interne bien décrite favorise une meilleure synthèse par les assistants comme Perplexity.
Étape 3 : créer le fichier complémentaire llms-full.txt (optionnel mais recommandé)
Le fichier llms-full.txt est le pendant exhaustif de votre index. Il est particulièrement utile pour les sites de documentation ou les bibliothèques logicielles où une lecture linéaire est possible.
Rassembler les contenus bruts sans balisage HTML superflu
Dans ce second fichier, vous allez copier le contenu textuel de vos pages principales les unes à la suite des autres. Attention : retirez tout ce qui n’est pas de l’information pure. Le code JavaScript, les balises de suivi publicitaire ou les éléments de navigation latérale doivent disparaître. L’objectif est de fournir du texte brut ou du Markdown propre. Cela réduit drastiquement le coût en tokens pour l’utilisateur final et évite les erreurs d’interprétation liées au code parasite.
Gérer la taille du fichier et la fenêtre de contexte
Même si les modèles récents acceptent des contextes de plus en plus larges, ne surchargez pas votre llms-full.txt inutilement. Si votre contenu dépasse les 100 000 mots, privilégiez plusieurs fichiers thématiques ou limitez-vous aux sections fondamentales. Un fichier trop lourd risque d’être tronqué ou ignoré par certains agents IA dont la mémoire de travail reste limitée. Pensez à vérifier périodiquement la pertinence des blocs insérés, surtout après une mise à jour majeure de vos services.
Étape 4 : déployer les fichiers à la racine de votre serveur web
Le déploiement est l’étape cruciale. Le fichier llms doit être accessible publiquement, sans authentification, pour être détecté automatiquement par les outils de scan.
Placer le fichier dans le dossier public (root)
Connectez-vous à votre serveur et téléversez llms.txt dans le répertoire racine. L’URL finale doit ressembler à https://votre-domaine.com/llms.txt. Si vous utilisez un CMS comme WordPress, placez-le dans le dossier où se trouve votre fichier wp-config.php. Pour les sites utilisant des frameworks comme Next.js ou Hugo, le fichier doit être placé dans le dossier /public ou /static afin d’être copié tel quel lors du build.
Configurer le bon Content-Type (text/plain ou text/markdown)
C’est ici que beaucoup se plantent : le serveur doit renvoyer le bon en-tête HTTP. Pour Nginx, vous pouvez ajouter cette directive dans votre bloc serveur :
location = /llms.txt {
    default_type text/markdown;
    charset utf-8;
}
Sur Apache, utilisez le fichier .htaccess :
<Files "llms.txt">
    AddType text/markdown .txt
</Files>
Assurer un encodage UTF-8 est indispensable pour la lecture des caractères accentués par les crawlers IA internationaux.
Étape 5 : tester et valider l’accessibilité de votre llms.txt
Avant de considérer le travail terminé, un contrôle technique s’impose. La simple lecture dans un navigateur ne suffit pas à valider les en-têtes HTTP.
Vérifier l’URL en direct via cURL ou navigateur
Ouvrez votre terminal et lancez la commande suivante : curl -I https://votre-domaine.com/llms.txt. Vous devez obtenir une réponse HTTP/1.1 200 OK ou HTTP/2 200. Vérifiez que la ligne Content-Type mentionne bien text/markdown ou text/plain. Si vous obtenez une erreur 404, vérifiez le chemin de déploiement. Si vous obtenez une 403, revoyez les permissions de lecture (CHMOD 644) sur votre serveur.
Tester l’interprétation par un agent IA (ex: Claude, Cursor ou ChatGPT)
Pour valider l’utilité réelle du fichier, utilisez un outil comme ChatGPT (avec la fonction Search activée) ou Claude. Envoyez un prompt du type : « Utilise le fichier llms.txt de mon site [URL] pour résumer mes services principaux ». Si l’IA restitue vos sections et vos descriptions sans inventer d’informations, votre formatage Markdown est lisible. Attention : ce test vérifie seulement que le fichier est compréhensible quand on le fournit à une IA, il ne prouve pas que les assistants le consultent d’eux-mêmes. Pour un contrôle technique, lancez aussi l’audit Lighthouse (catégorie Agentic Browsing), qui vérifie la présence du fichier, son titre H1 et l’usage de liens au format Markdown.
Conseils pratiques et erreurs fréquentes à éviter
L’implémentation d’un llms txt fichier demande de la rigueur pour ne pas produire l’effet inverse de celui recherché. La sobriété est votre meilleure alliée.
Erreur 1 : transformer le llms.txt en sitemap géant ou bourrage de mots-clés
Ne listez pas chaque article de blog depuis 2010. Le llms txt n’est pas un sitemap.xml. Son but est de fournir des raccourcis vers les connaissances structurantes. Si vous saturez le fichier de liens inutiles, vous diluez l’autorité des pages importantes. Un maximum de 20 à 30 liens pour l’index principal est une bonne pratique. Au-delà, l’agent IA risque de perdre le fil du contexte principal du site.
Erreur 2 : oublier de mettre à jour les urls après une refonte
Un lien mort dans votre fichier llms est plus préjudiciable qu’un lien mort sur une page HTML. L’IA, n’ayant pas de repère visuel, peut se retrouver bloquée ou fournir des informations obsolètes. Intégrez la mise à jour de ce fichier dans votre checklist de déploiement. Si vous modifiez vos structures d’URL, utilisez des redirections 301, mais mettez à jour le fichier Markdown immédiatement pour économiser les ressources de crawl.
Erreur 3 : bloquer le fichier dans le robots.txt
C’est le paradoxe classique. Certains webmasters bloquent l’accès aux robots IA (via User-agent: GPTBot / Disallow: /) tout en essayant de proposer un llms.txt. Assurez-vous que vos règles de blocage n’empêchent pas la lecture spécifique de ce fichier. Vous pouvez autoriser explicitement le fichier en ajoutant Allow: /llms.txt dans votre configuration robots.txt, même si vous restreignez le reste du site.
Variantes et automatisation : aller plus loin avec votre llms.txt
Pour les sites volumineux ou les plateformes SaaS, la maintenance manuelle devient vite chronophage. L’automatisation permet de garantir une synchronisation parfaite avec vos contenus réels.
Gérer automatiquement le llms.txt via un script de build (Node, python, CMS)
Si vous utilisez un générateur de site statique, vous pouvez scripter la création du fichier. Par exemple, un script Node.js peut extraire les titres et les résumés de vos fichiers Markdown sources pour générer le llms txt fichier à chaque déploiement. Pour WordPress, des fonctions simples via le fichier functions.php permettent de générer dynamiquement le contenu du fichier lors de chaque appel à l’URL dédiée, en interrogeant la base de données pour extraire les pages piliers.
Adapter le fichier pour les bibliothèques de code et apis
Dans le cas d’une documentation technique, le fichier llms peut pointer vers des fichiers .md spécifiques contenant des exemples de code. Cela permet aux assistants de programmation (comme Cursor ou GitHub Copilot) de comprendre plus vite comment utiliser vos outils. Vous pouvez même créer des variantes thématiques si votre site couvre des domaines très différents, en utilisant des liens vers des sous-fichiers llms-thématique.txt, respectant ainsi une logique de navigation agentique claire.
Un dernier point souvent oublié : la mise en place d’un llms.txt ne remplace en rien un bon référencement naturel classique. C’est une couche supplémentaire. En facilitant la tâche des modèles de langage, vous augmentez simplement vos chances d’être cité précisément lors des réponses générées par les IA. Pour aller plus loin dans l’optimisation de vos ressources, consultez notre guide netlinking et SEO génératif, et notre méthode pour mesurer la présence de votre marque dans ChatGPT.
En cas de problème technique
| Symptôme observé | Cause probable | Correction |
|---|---|---|
| L’IA ne trouve pas le fichier | Emplacement erroné ou blocage robots.txt | Vérifier la présence à la racine du site |
| Formatage illisible dans l’IA | Mauvais encodage ou syntaxe Markdown invalide | Forcer l’UTF-8 et valider le H1 initial |
| Erreur 403 (Forbidden) | Droits d’accès insuffisants sur le serveur | Modifier les permissions en CHMOD 644 |
Foire aux questions sur le llms.txt
Le fichier llms.txt remplace-t-il le sitemap.xml ?
Non, ce sont deux outils aux fonctions distinctes. Le sitemap.xml aide les moteurs comme Google à indexer toutes vos pages. Le llms.txt est un condensé stratégique destiné aux agents IA pour leur éviter de traiter des données inutiles. Ils sont complémentaires et doivent cohabiter pour un meilleur trafic organique.
Où doit-on placer le fichier llms.txt sur un site web ?
Il doit impérativement se situer à la racine du site. Par exemple : https://mon-site.fr/llms.txt. C’est l’emplacement prévu par la spécification. Placé dans un sous-dossier, il ne sera pas trouvé par les outils qui le recherchent, comme l’audit Lighthouse.
Quelle est la différence entre llms.txt et llms-full.txt ?
Le llms.txt est un index synthétique contenant des liens et des résumés. Le llms-full.txt est une version agrégée qui contient le texte complet des ressources listées. Le second permet à une IA de lire l’intégralité de vos documents essentiels en une seule requête, optimisant ainsi sa fenêtre de contexte.
Les assistants comme ChatGPT utilisent-ils vraiment ce fichier ?
Rien ne le confirme à ce jour. En juin 2025, John Mueller (Google) a indiqué qu’aucun système d’IA n’utilisait llms.txt, et aucun grand éditeur d’IA (OpenAI, Anthropic, Google, Perplexity) n’a annoncé officiellement le lire pour choisir ses sources. Les signaux de Google restent d’ailleurs contradictoires : son outil Lighthouse intègre depuis mai 2026 un audit llms.txt dans sa catégorie « Agentic Browsing », destiné aux agents qui naviguent sur un site, sans lien annoncé avec le classement. Créer le fichier reste un pari peu coûteux : il ne garantit aucune citation en GEO.

